
前 14 天,我們已經陸續碰過 Kubernetes 裡很多重要的概念:
Cluster
Namespace
Pod
Deployment
ReplicaSet
Rolling Update
Service
DNS
FastAPI
Docker Image
ConfigMap
Secret
Redis
PostgreSQL
PVC
Probe
Resources
到目前為止,我們做的大多數事情,都是「把系統建立起來」。
建立 Deployment、建立 Service、掛上 PVC、設定 Probe,最後確認:
Pod Running
Service 可以連
API 正常回應
但今天不一樣。
今天我們不新增任何新的 Kubernetes Resource,也不急著學新的 YAML。
今天只做一件事:
故意把系統弄壞,然後把它修回來。
因為真正決定你會不會 Kubernetes 的,往往不是:
你能不能把一份正確的 YAML apply 成功
而是當你看到:
服務壞了
你能不能判斷:
問題到底發生在哪一層?
下一個最值得執行的指令是什麼?
這也是 Kubernetes Troubleshooting 最重要的能力。
很多人在遇到服務有問題時,第一個直覺可能是:
kubectl delete pod
想說把 Pod 刪掉,讓 Deployment 幫忙重建一個新的。
或者更極端一點:
重開 Docker Desktop
重建 kind Cluster
有時候這些方法的確會「暫時讓問題消失」,但它們沒有回答真正重要的問題:
剛剛到底為什麼壞掉?
如果根本原因沒有找到,同樣的問題之後還是會再出現。
因此從今天開始,我們要慢慢建立一條固定的 Troubleshooting Pipeline。
當有人跟你說:
API 掛了
第一件事情不要急著改東西,而是先觀察現在的狀態。
最基本的一步就是:
kubectl get pods -n cka-lab
先回答:
Pod 現在到底是什麼狀態?
因為不同的 Pod 狀態,代表問題很可能發生在完全不同的地方。
如果你看到:
Pending
這通常代表 Pod 已經被建立出來了,但是還沒有成功被排程並啟動。
換句話說,這時候 Application 很可能根本還沒開始執行。
因此第一個該看的通常不是:
kubectl logs
因為 Container 可能根本還不存在,自然也不會有什麼 Application Log 可以看。
這時候更重要的是:
kubectl describe pod POD_NAME -n cka-lab
接著往下面找:
Events
Events 通常會直接告訴你 Kubernetes 為什麼無法讓這顆 Pod 啟動。
例如可能看到:
Insufficient cpu
Insufficient memory
代表 Node 資源不夠。
也可能是:
nodeSelector 不符合任何 Node
或者之後我們會學到的:
Taint / Toleration
Affinity
PVC 無法 Bound
Scheduling Failure
所以當你看到:
Pending
可以先建立一個很重要的直覺:
這通常比較像是 Scheduling 或 Infrastructure 層的問題,而不是 Application 本身的問題。
另外一種很常見的錯誤是:
ImagePullBackOff
這個名稱其實已經給了很大的提示。
Kubernetes 想建立 Container,但是在抓 Docker Image 的時候失敗了。
因此這時候第一個重要指令一樣是:
kubectl describe pod POD_NAME -n cka-lab
往 Events 看,通常就能看到像:
Failed to pull image
接著你就要開始檢查:
Image 名稱是不是打錯?
Tag 存不存在?
Registry 能不能存取?
Private Registry 是否缺少 Credential?
例如 Deployment 寫成:
image: cka-api:v999
但實際上根本沒有:
v999
這顆 Image,那 Kubernetes 當然永遠抓不到。
這時候去看:
kubectl logs
通常沒有太大意義。
因為 Application 根本還沒啟動。
所以:
ImagePullBackOff
要先想到的是:
Image / Registry
而不是 Application Code。
如果看到:
CrashLoopBackOff
情況就不太一樣了。
這通常代表 Container 其實有成功啟動,但是啟動之後很快就 Crash。
Kubernetes 發現 Container 死掉後,就會重新啟動它。
結果 Application 再次 Crash。
於是就會變成:
Start
↓
Crash
↓
Restart
↓
Crash
↓
Restart
因此這種情況,Application Log 就非常重要。
可以先執行:
kubectl logs POD_NAME -n cka-lab
看看程式到底報了什麼錯誤。
例如可能會看到:
Database connection failed
Environment variable missing
Module not found
Port already in use
但 CrashLoopBackOff 還有一個很重要的技巧。
因為 Container 可能已經被重新啟動過,現在這一輪 Log 不一定包含真正讓上一輪 Container 掛掉的錯誤。
這時可以使用:
kubectl logs POD_NAME \
  -n cka-lab \
  --previous
--previous 代表:
查看上一個已經死亡的 Container Log
這在考 CKA 或實際 Production Troubleshooting 時都非常實用。
有時候你會看到:
NAME        READY   STATUS
api-xxxxx   0/1     Running
這種畫面很容易讓人困惑:
既然 STATUS 都 Running 了,
為什麼 READY 還是 0/1?
原因就在於:
Running
和:
Ready
不是同一件事情。
Running 只代表:
Container Process 還活著
但是 Kubernetes 還會透過 Readiness Probe 判斷:
這個 Pod 現在適不適合接收流量?
因此如果看到:
0/1 Running
很值得先懷疑:
Readiness Probe
可以執行:
kubectl describe pod POD_NAME -n cka-lab
往下找 Events。
可能看到:
Readiness probe failed
甚至會直接告訴你:
HTTP probe failed with statuscode: 404
這時候問題就非常明確了。
Container 沒死,但是 Kubernetes 判定它還沒準備好接收流量。
這是 Troubleshooting 開始變得比較有趣的地方。
假設你看到:
READY
1/1

STATUS
Running
代表 Pod 本身看起來沒有問題。
但是:
curl API
還是打不到。
這時候就不能一直盯著 Pod 看了。
因為 Kubernetes 的請求路徑通常不是:
Client
↓
Pod
而是:
Client
↓
Service
↓
Endpoint
↓
Pod
所以 Pod 正常,不代表 Service 一定正常。
這時候可以先看:
kubectl get svc -n cka-lab
確認 Service 是否存在。
接著看:
kubectl get endpointslices -n cka-lab
EndpointSlice 可以理解成 Kubernetes 幫 Service 維護的:
真正 Backend Pod 清單
假設 Service 存在,但是 EndpointSlice 裡完全沒有 API Pod,那就代表:
Service 找不到任何可以轉送流量的 Pod
這時可以再看:
kubectl get pods \
  -n cka-lab \
  --show-labels
開始比較:
Service selector
和:
Pod labels
到底有沒有對上。
我們先做第一個故障實驗。
目前正常的 API Service Selector 應該類似:
selector:
  app: api
也就是告訴 Kubernetes:
這個 Service
要把流量送給
app=api 的 Pod
現在我們故意把它改錯:
kubectl patch service api \
  -n cka-lab \
  -p '{"spec":{"selector":{"app":"broken"}}}'
現在假裝你不知道剛才改了什麼,只知道:
API 突然打不到了
首先看:
kubectl get pods -n cka-lab
你會發現 Pod 還是:
1/1 Running
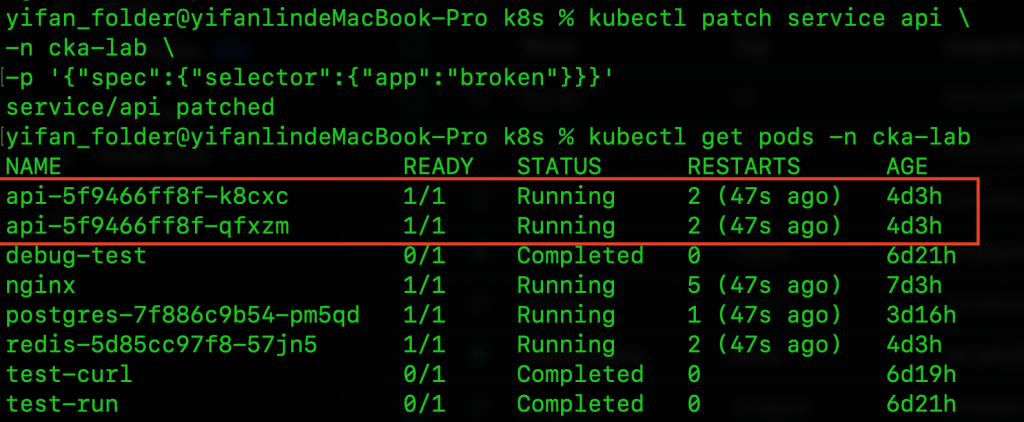
所以問題不像是在 Application。
接著:
kubectl get svc -n cka-lab
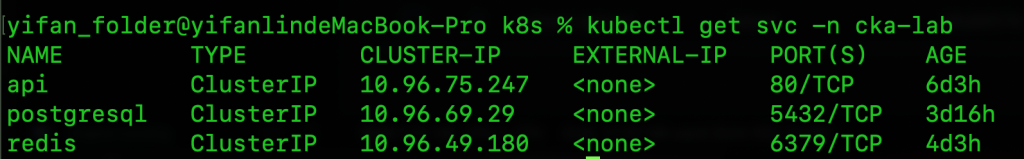
Service 也還存在。
這時候真正關鍵的是:
kubectl get endpointslices -n cka-lab
你會發現 API Service 底下沒有正確的 Backend。
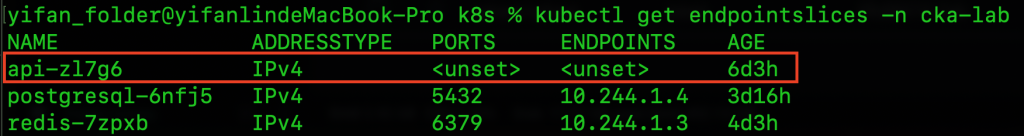
接著:
kubectl get pods \
  -n cka-lab \
  --show-labels
比較一下就會發現:
Service selector
app=broken
但是 Pod 是:
app=api
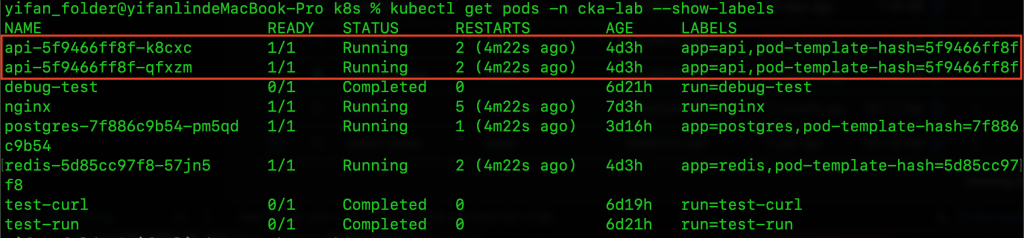
Service 本質上就是透過 Label Selector 找 Pod。
兩邊一旦對不上:
Service
↓
找不到任何 Pod
因此修正:
kubectl patch service api \
  -n cka-lab \
  -p '{"spec":{"selector":{"app":"api"}}}'
可以發現 endpointslices 那些都恢復了
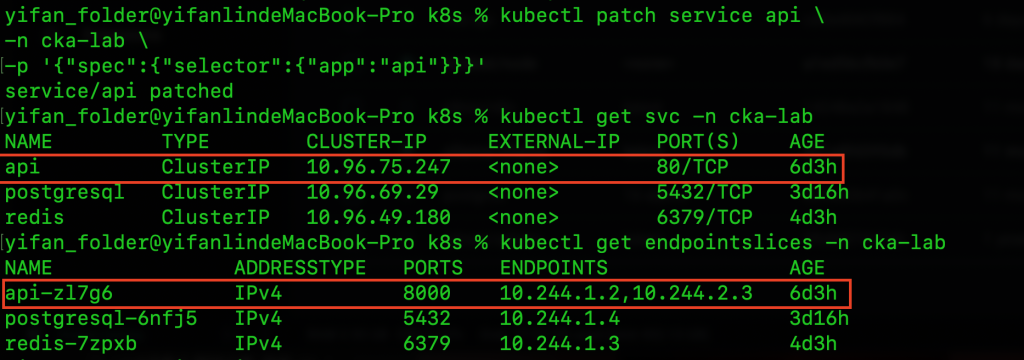
app: api。endpointslice-controller 偵測到 Service 條件變更,立即找出所有標籤為 app=api 且健康檢查(Readiness Probe)通過的 Pod。kube-proxy 看到 EndpointSlice 更新,立刻在節點上重寫底層轉發規則(iptables 或 IPVS)。這個 Lab 最重要的不是記住 patch 指令,而是建立一個排查路線:
Pod 正常
↓
Service 存在
↓
但流量不通
↓
檢查 Endpoint
↓
檢查 Service selector 與 Pod label
接下來故意把 Deployment 改成一個不存在的 Image:
kubectl set image \
  deployment/api \
  api=cka-api:v999 \
  -n cka-lab
Deployment 會開始 Rolling Update,嘗試建立新的 Pod。
查看:
kubectl get pods -n cka-lab
應該很快就會看到:
ImagePullBackOff
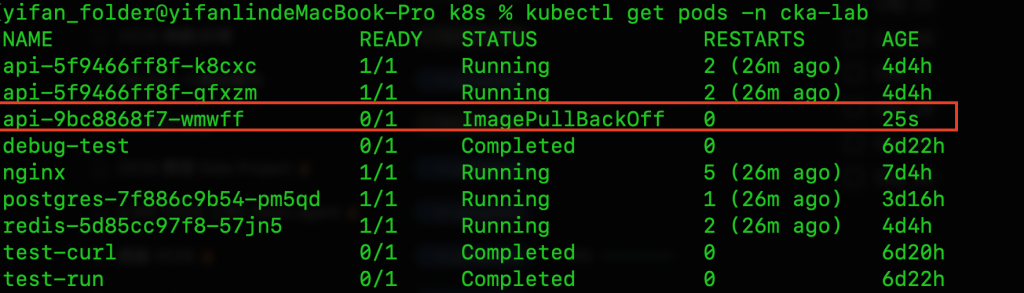
這時候不要急著亂改設定。
先:
kubectl describe pod BROKEN_POD \
  -n cka-lab
往 Events 看。
應該能找到類似:
Failed to pull image
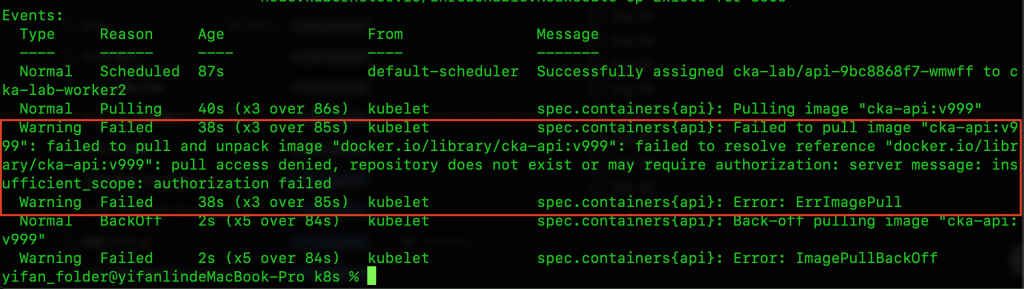
這時候你已經可以推斷:
問題發生在 Image
而不是 Application
因為我們是故意製造錯誤,所以修復方式很簡單:
kubectl rollout undo \
  deployment/api \
  -n cka-lab
這會把 Deployment 回滾到上一個 Revision。
也就是:
v999
↓
上一個正常 Image
接著我們故意把 Readiness Probe 改錯。
假設原本 Application 有:
/health/ready
我們把 Deployment 裡面的 Readiness Path 改成:
/health/not-exist
新的 Pod 建立之後,你應該會看到:
0/1 Running
注意這個狀態。
Container 本身有啟動,因此:
STATUS = Running
但是 Readiness Probe 一直打:
/health/not-exist
Application 回:
404
所以 Kubernetes 認為:
這個 Pod 還不能接收流量
這時候第一個重要動作應該是:
kubectl describe pod POD_NAME -n cka-lab
查看 Probe Failure。
而不是:
kubectl delete pod POD_NAME
為什麼?
因為這次真正出錯的地方不是 Pod 本身。
而是:
Deployment Template
Deployment Template 裡面寫的 Probe Path 就是錯的。
如果你只是刪掉 Pod:
Deployment
↓
看到少一顆 Pod
↓
重新建立新的 Pod
↓
新的 Pod 又使用同一份錯誤 Template
↓
繼續 0/1 Running
所以你會一直刪,一直生出錯誤的新 Pod。
這也帶出 Kubernetes Troubleshooting 一個非常重要的觀念:
不要只修眼前看到的症狀,要找到 Desired State 到底哪裡設定錯了。
Kubernetes 的核心就是 Declarative Desired State。
Deployment 寫著什麼,Kubernetes 就會一直努力讓現實世界變成那個樣子。
如果:
Desired State 本身就是錯的
那 Kubernetes 只會非常努力地:
把錯誤狀態重新建立出來。
最後來看一個比前面更貼近真實系統的案例。
現在我們的 Application 已經不是單獨存在。
架構大概是:
Client
↓
Service api
↓
API Pod
↓
Service redis
↓
Redis Pod
如果我們故意把 Redis Service 的 Selector:
selector:
  app: redis
改成:
selector:
  app: broken
這時候有一件事情很有趣。
API Container 本身可能仍然:
Running
甚至:
1/1 Running
因為 FastAPI Process 沒有死。
但是當使用者呼叫:
/
API 內部要執行:
redis_client.incr("visits")
這時候才會發現 Redis 根本連不上。
所以使用者看到的可能是:
500 Internal Server Error
這個案例提醒我們:
Application 出錯,不代表 Application Pod 本身一定有問題。
今天的系統已經有 Dependency 之後,Troubleshooting 必須沿著整條 Request Path 思考。
例如:
Application
↓
DNS
↓
Service
↓
Endpoint
↓
Redis Pod
假設 API Log 顯示:
Connection refused
你就不能只一直檢查 API Deployment。
還必須進一步確認:
redis 這個 DNS 名稱是否正確?
Redis Service 是否存在?
Redis Service 有沒有 Endpoint?
Redis Pod 是否 Running?
Service Selector 是否選得到 Redis Pod?
這也是微服務 Troubleshooting 很重要的一個轉變:
不要只看「哪一顆 Pod 報錯」
而是要看:
整條請求路徑到底在哪裡斷掉。
Kubernetes 指令很多。
但是 Troubleshooting 一開始,其實不需要先背幾十種 Command。
真正最重要的,是熟悉幾個最常用的觀察工具。
第一個:
kubectl get
它是在回答:
現在整個世界長什麼樣?
例如:
kubectl get pods
kubectl get svc
kubectl get deployments
kubectl get endpointslices
讓你先快速建立全貌。
第二個:
kubectl describe
它是在回答:
這個 Object 現在到底發生了什麼?
特別重要的是底部的:
Events
Scheduling、Probe、Image Pull 等很多 Kubernetes 層的錯誤,都可以從這裡找到線索。
第三個:
kubectl logs
它是在回答:
Application 自己說了什麼?
例如 Python Exception、Redis Connection Error、Database Error 等等。
第四個:
kubectl get events
它可以讓你從 Cluster 的角度觀察最近到底發生了什麼。
例如:
kubectl get events \
  -n cka-lab \
  --sort-by=.metadata.creationTimestamp
就可以依照時間順序查看近期事件。
第五個:
kubectl exec
有時候光看外面還是不夠。
你會需要直接進 Container 裡面驗證:
DNS 能不能 Resolve?
Service 能不能 Connect?
Environment Variable 有沒有正確注入?
檔案到底存不存在?
例如:
kubectl exec -it POD_NAME \
  -n cka-lab \
  -- sh
進入 Container 後,你就可以從 Application 的視角檢查整個環境。
學 Kubernetes 很容易陷入一個誤區:
我是不是還少背了什麼指令?
但 Troubleshooting 真正重要的不是:
記住 100 個 kubectl Command
而是看到一個症狀時,知道:
下一個最有資訊價值的動作是什麼?
例如:
Pending
先想到:
利用 kubectl describe 看裡面的
→ Events
→ Scheduling
看到:
ImagePullBackOff
先想到:
kubectl describe
→ Image Pull Error
看到:
CrashLoopBackOff
先想到:
logs
logs --previous
看到:
0/1 Running
先想到:
Readiness Probe
看到:
1/1 Running
但 Service 打不到
開始想到:
Service
↓
Endpoint
↓
Selector
↓
Label
真正熟悉 Kubernetes,就是慢慢把這些:
症狀
↓
推理
↓
驗證
變成直覺。
走到 Day 15,我們已經不只是會建立一顆 nginx Pod。
現在的架構已經逐漸變成一個完整的小型 Application Stack:
Mac
│
└── kind Kubernetes
      │
      ├── Control Plane
      │
      ├── Worker
      │
      └── Worker
            │
            ▼
        Service api
            │
            ▼
       API Deployment
            │
         API Pods
          │    │
          │    └──────────────┐
          │                   │
          ▼                   ▼
     Service redis      Service postgres
          │                   │
          ▼                   ▼
      Redis Pod         PostgreSQL Pod
                              │
                              ▼
                             PVC
前 14 天,我們比較像是在學:
怎麼把這些東西建立起來。
Day 15 則第一次開始反過來思考:
它壞掉之後,我怎麼知道哪裡出了問題?
而我們也已經實際看過:
ImagePullBackOff
Readiness Failure
Service Selector Error
Dependency Failure
Pod Replacement
Rolling Update
Rollback
Persistent Storage
所以到這裡,其實已經完成 Kubernetes 第一個很重要的階段。
如果要用一句話總結前 15 天,就是:
Application 要怎麼在 Kubernetes 裡面正常活起來?
我們從 Container 開始,一路理解:
Pod
↓
Deployment
↓
ReplicaSet
↓
Service
↓
DNS
↓
ConfigMap / Secret
↓
Redis / PostgreSQL
↓
PVC
↓
Probe
↓
Resources
↓
Troubleshooting
也就是開始具備:
把一個 Application 放進 Kubernetes
並讓它正常運作
的基本能力。
明天開始,學習的方向會開始改變。
接下來不再只是思考:
Application 怎麼跑?
而是開始思考:
如果我是 Kubernetes Administrator,我要怎麼控制整個 Cluster?
例如:
這顆 Pod 應該放在哪一台 Node?
會開始碰到:
Scheduling
nodeSelector
Affinity
Taint / Toleration
如果流量變多:
Pod 要怎麼自動擴展?
會進入:
HPA
如果有定時任務:
Job
CronJob
如果每一台 Node 都必須跑一顆 Agent:
DaemonSet
如果想限制 Pod 彼此之間的網路:
NetworkPolicy
如果想控制:
誰可以操作 Kubernetes?
就會進入:
RBAC
之後還會一路碰到:
Gateway API
Helm
Kustomize
Control Plane
kubelet
etcd Backup / Restore
GitHub Actions
GitOps
CKA Final Troubleshooting
所以前 15 天比較像是在完成:
Developer 視角的 Kubernetes
開始知道:
Application 怎麼部署
Service 怎麼串
Config 怎麼帶進來
資料怎麼保存
服務怎麼做健康檢查
而 Day 16 之後,就會慢慢往:
Administrator 視角
前進。
也就是從:
把東西部署到 Kubernetes
正式開始走向:
我知道 Kubernetes 為什麼這樣運作,
出了問題也知道要去哪裡查。
這才是從「會用 Kubernetes」,真正開始進入「會管理 Kubernetes」的分水嶺。
我們明天見!


 iThome鐵人賽
 看影片追技術